Reddit コメント スクレイパー: Reddit スレッドを CSV または JSON にエクスポートする
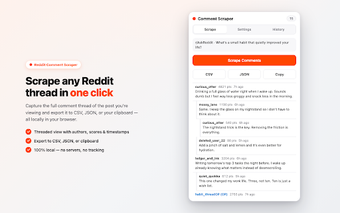
Reddit コメントスクレイパー - CSV & JSON エクスポート、開発者から、研究者やアナリストのために Reddit のディスカッションを抽出します。ユーザーは、質的および量的ワークフローをターゲットにして、単一のアクションで構造化された CSV または JSON ファイルとして完全なコメントツリーを保存できます。このツールは、下流の分析や報告のために Reddit の会話に迅速にアクセスする必要がある研究、ジャーナリズム、マーケティングチームのためのシンプルなキャプチャとエクスポートを強調しています。
スクレイパーは何を収集するために作られ、誰が最も恩恵を受けるのか?
この拡張機能は、個々のReddit投稿からコメントスレッドを収集することに焦点を当てており、市場調査員、データサイエンティスト、ジャーナリスト、分析のために会話データを必要とする学生に適しています。単一スレッドの抽出をサポートし、議論の内容を標準的な分析パイプラインに移動させることを明示的に目的としています。 ユースケース には、感情研究、顧客フィードバックの集約、学術研究が含まれ、会話の文脈を保持することが重要です。
クラウドツールと比較して、プライバシーとデータフローをどのように扱いますか?
この拡張機能は、スクレイピングされたデータを完全にブラウザ内で処理し、コンテンツを開発者のサーバーに送信しないため、クラウドアップロードの要件や外部アカウントを排除します。APIキーなしでRedditの公開エンドポイントにアクセスし、開発者に関連するリモートストレージを回避します。この設計により、データはユーザーのマシンに保持され、抽出ステップのためのサードパーティのインフラへの依存が減ります。
プログラマーでない人にとって使いやすく、研究ワークフローに繰り返し使用できるものですか?
ポップアップベースのノーコードインターフェースにより、ユーザーは含めるフィールドを選択し、ローカル履歴から過去のセッションを再開できるため、スクリプトなしで反復作業が容易になります。ユーザーは、著者、スコア、タイムスタンプ、本文などのメタデータを選択できます。拡張機能は、エクスポートされたファイル内で返信のネストを保持するため、スレッド構造とメタデータはスプレッドシートおよびプログラム分析の両方に利用可能です。
どのようにスケールし、ユーザーはどのような実用的な制限を期待すべきですか?
バルクエクスポートは、複数のオープンなRedditタブからコメントを1つのファイルにまとめることができ、バッチ収集を迅速化しますが、処理負荷がブラウザに移ります。すべての処理がローカルで実行されるため、リソースの需要はオープンタブの数とスレッドのサイズに依存します。非常に大きなバッチはブラウザを遅くする可能性があります。この拡張機能はChromeおよび他のChromiumベースのブラウザで利用可能であるため、大規模なエクスポート中にリソースを管理するために専用プロファイルでのテストが役立ちます。
ローカルで繰り返し可能なRedditデータ収集のための集中ツール
この拡張機能は、外部アカウントなしでRedditの会話に直接アクセスする必要がある研究者やアナリストにとって実用的な選択肢です。トレードオフを期待してください:ローカル処理は計算をブラウザ上で行うため、適度なバッチでの収集を計画してください。ヒント:専用のブラウザプロファイルを使用し、結果のCSVまたはJSONを好みの分析環境にインポートして、ワークフローを整然とし、再現可能に保ちましょう。